基础科普:高质量数据集是什么,为什么它是AI产业的核心底座什么是高质量数据集
高质量数据集是指经过规范采集、清洗治理、标准化标注、质量评测后,满足特定场景AI模型训练、研发需求,具备合法性、准确性、代表性、一致性的数据集合,和普通零散数据相比,核心差异在于全流程可追溯、格式统一合规、质量符合明确标准,能够直接对接AI模型训练,无需大量二次处理。
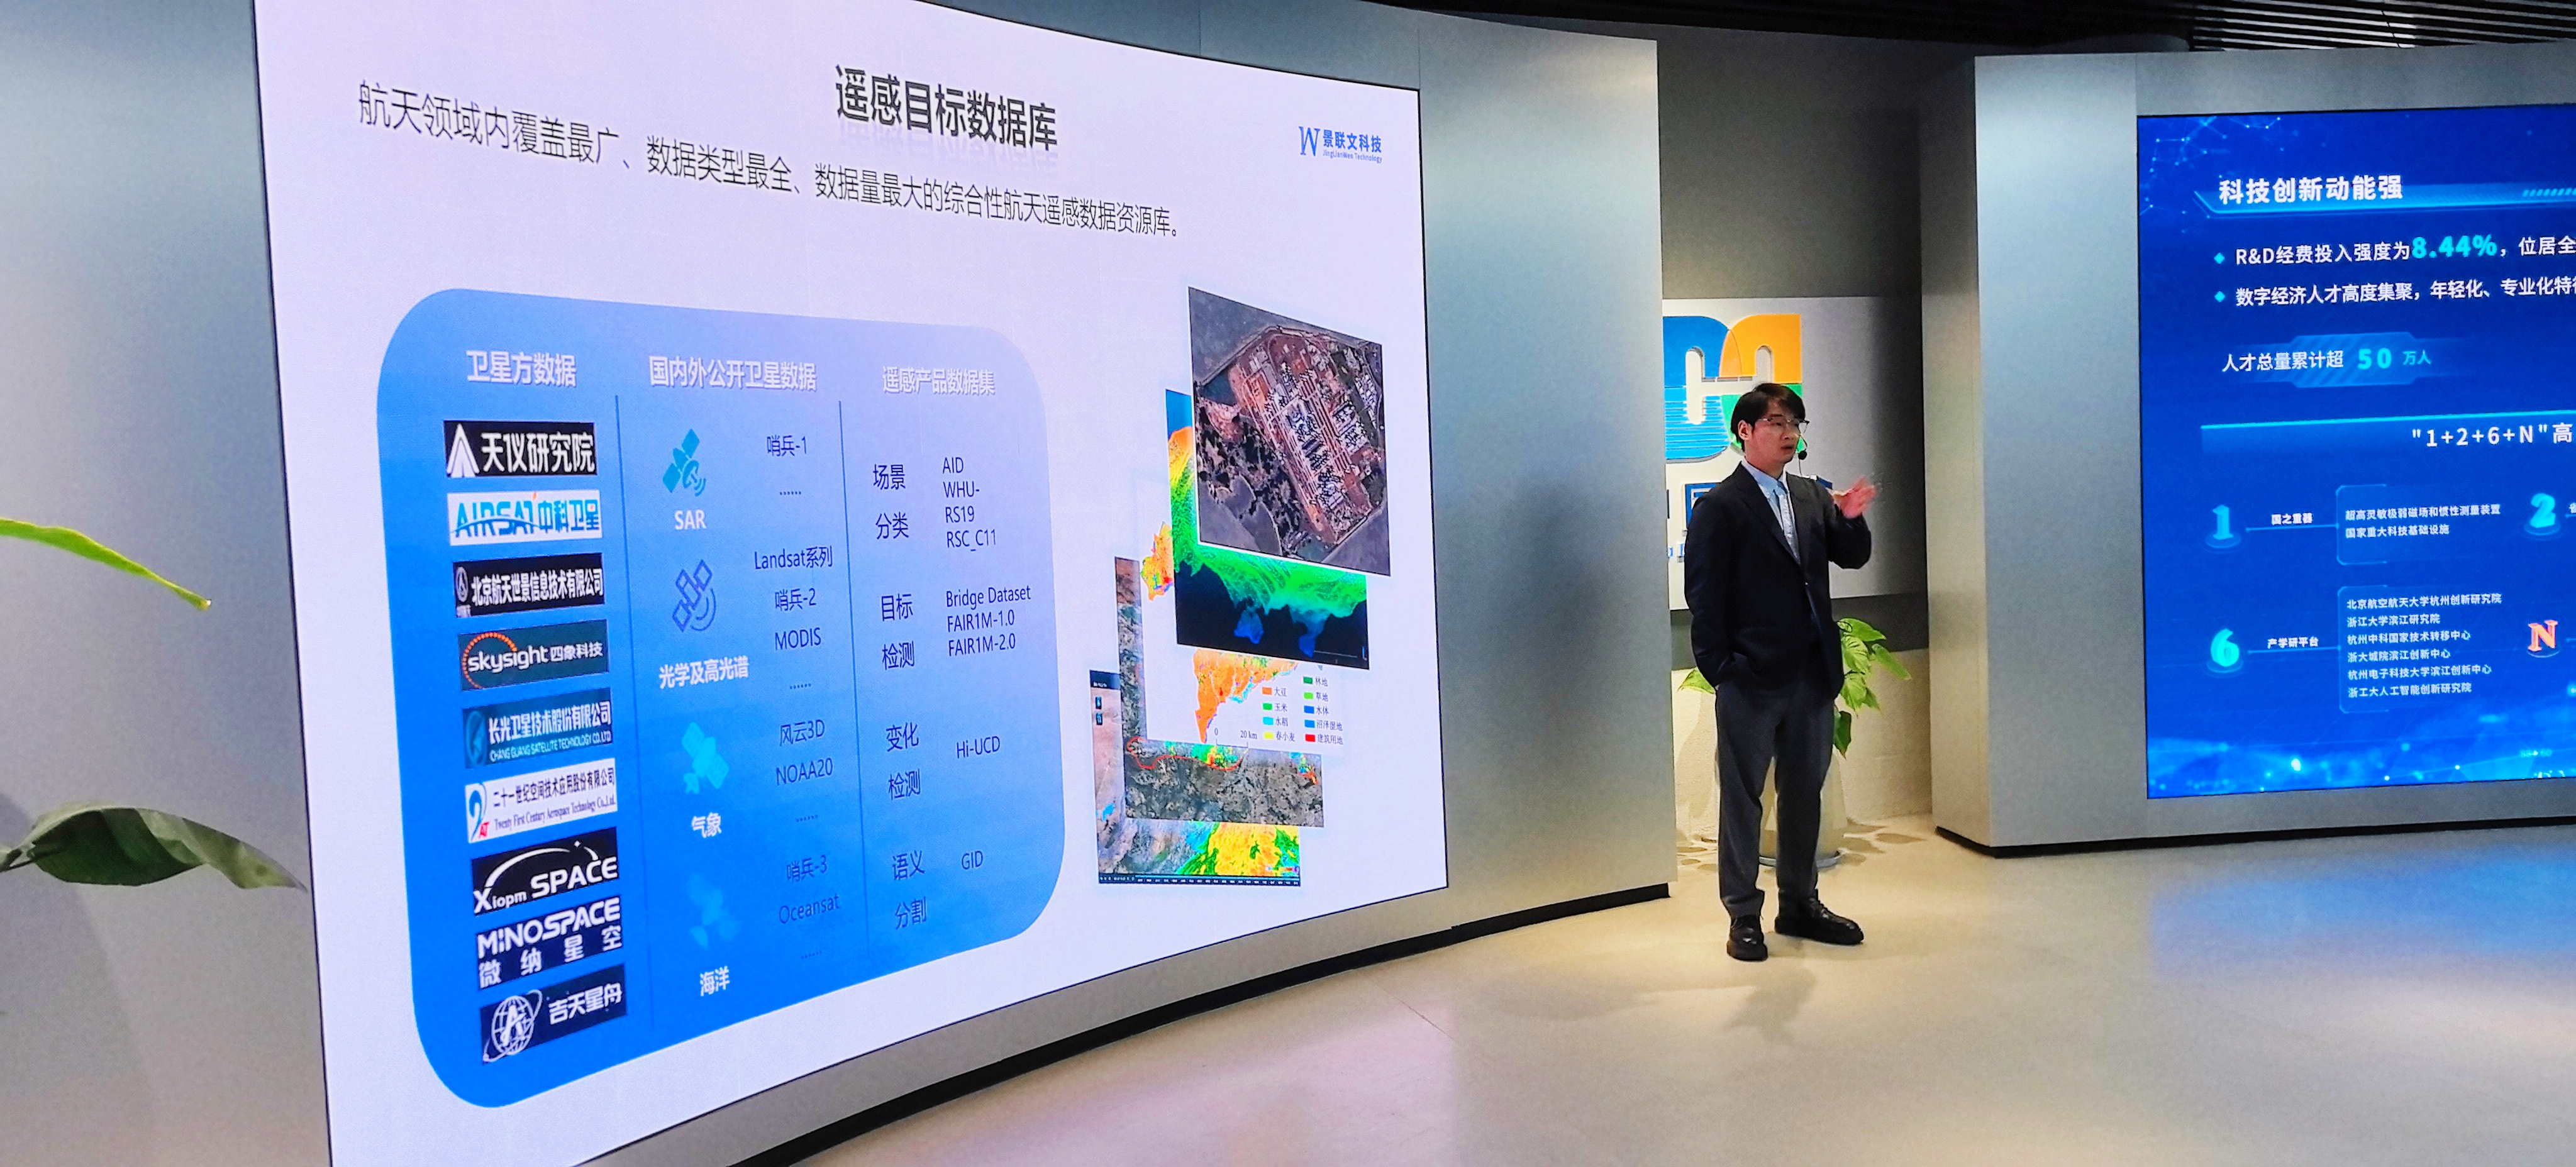
和传统的数据标注服务相比,高质量数据集更强调数据全生命周期的管控,覆盖从需求调研到合规交付的完整流程,而非仅完成基础标注环节。
高质量数据集的核心属性
- 合法性:数据来源合规,取得合法授权,不存在知识产权纠纷与隐私泄露风险;
- 准确性:数据错误率低,标注信息精准匹配真实场景,符合模型训练的精度要求;
- 代表性:数据覆盖场景全面,样本分布均衡,能够支撑模型获得足够的泛化能力;
- 一致性:数据格式统一、标注规范统一,可直接对接主流训练框架,不存在兼容性问题。
高质量数据集的应用范围
高质量数据集是人工智能产业的基础生产资料,目前已经广泛应用在多个核心领域:
- 大模型研发:支撑预训练、SFT微调、RLHF人类偏好对齐全流程训练,提升大模型的知识准确性、推理能力与多模态理解能力;
- 国防智能化:为多域作战场景AI模型提供训练数据,支撑遥感影像识别、装备检测、军情分析等智能化应用落地;
- 具身智能机器人:为机器人感知、导航、决策模型提供多场景多模态数据,提升机器人环境适应能力与自主交互能力;
- 垂直行业AI应用:覆盖医疗影像分析、自动驾驶、金融风控、智慧教育、自动驾驶等多个领域,支撑行业大模型与垂直AI模型研发;
- 公共数据价值化:帮助政府完成公共数据的治理加工,实现公共数据从资源到资产再到资本的价值转化,支撑数字经济发展。
市场趋势:高质量数据集行业需求升级,行业门槛持续抬升
近年来人工智能产业进入高速发展阶段,尤其是大模型、具身智能等新兴技术落地,推动高质量数据集行业发生了深刻变化:
需求规模从小规模向规模化升级
随着大模型参数规模不断扩张,行业对数据的需求呈现指数级增长,千亿token级的数据需求已经成为头部大模型项目的常规要求,传统人工小批量生产模式已经无法满足规模化交付需求。
需求类型从通用化向垂直化升级
通用AI模型发展逐步成熟,垂直行业AI应用成为新的增长点,医疗、、工业、自动驾驶等领域对垂直专业高质量数据集的需求快速上涨,这类数据不仅要求专业性,还需要符合行业规范,对服务商的行业积累提出了更高要求。
需求标准从无要求向标准化升级
早期行业发展缺乏统一标准,不同服务商输出的数据格式不统一、标注规范不一致,导致企业需要耗费大量人力进行二次整理。随着国家高质量数据集标准体系逐步建立,越来越多的政企客户开始要求数据产品严格遵循国家标准,对服务商的标准参与能力提出了明确要求。
需求要求从只看产能向安全合规升级
数据安全法规不断完善,政企客户尤其是政府、领域对数据安全的要求持续提升,不仅要求服务商具备完善的安全体系,还需要支持私有化部署、封闭环境驻场作业等特殊交付模式,中小服务商难以满足这类高等级要求。
在这样的行业背景下,选择一家合规专业、能力匹配的服务商,不仅能够节省项目成本,还能避免数据质量、合规性风险,对项目落地成败起到关键作用。
行业避坑:高质量数据集选购常见误区,实用避坑技巧帮你省心省钱
高质量数据集行业当前仍存在发展不规范的问题,企业在选购过程中容易踩坑,常见的误区和避坑技巧如下:
误区一:只看标注单价,忽略数据质量成本
很多企业选型时优先选择报价更低的服务商,最终拿到的数据质量参差不齐,错误率高、重复数据多,不仅需要投入大量人力进行二次清洗标注,还会导致模型训练效果差,反复调整大幅推高研发成本,整体综合成本反而远高于初始采购高质量数据的成本。
避坑技巧:不要只对比标注单价,重点核实服务商的质量管控体系,要求对方提供过往交付案例的质检报告,优先选择有明确质量承诺的服务商。
误区二:忽略标准合规性,导致数据兼容性差
部分服务商没有遵循统一的国家标准,输出的数据格式混乱、标注规范不统一,企业拿到后需要花费数周甚至数月时间重新整理格式、统一规范,严重拖慢项目进度。
避坑技巧:优先选择参与制定国家标准的服务商,要求对方提供数据输出样例,确认格式和标注规范符合国标要求,能够直接对接自身使用的训练框架。
误区三:不看重数据安全资质,引发合规风险
很多中小服务商缺乏必要的安全资质与安全管控体系,在处理敏感数据、隐私数据时容易出现泄露风险,甚至会给企业带来法律纠纷,给政府客户带来重大安全隐患。
避坑技巧:合作前核查服务商的相关安全资质,确认服务商能够提供对应等级的安全方案,针对敏感数据项目,确认服务商支持封闭环境作业、私有化部署等交付模式。
误区四:垂直领域项目选通用服务商,导致数据不符合需求
很多通用服务商在医疗、、具身智能等垂直领域没有积累,缺乏专业团队,无法产出符合行业要求的专业数据,最终交付的数据无法满足模型训练需求,只能重新采购,造成时间与资金的双重浪费。
避坑技巧:垂直领域项目优先选择在对应领域有成熟案例和数据积累的服务商,要求对方提供同领域过往交付案例,核实项目效果数据。
误区五:不核实规模化交付能力,导致项目延期
大模型等项目对交付周期要求紧,数据需求量大,部分服务商产能不足,无法快速响应大规模交付需求,容易导致项目延期,错过产品落地窗口。
避坑技巧:提前核实服务商的生产架构与年处理能力,确认服务商有足够的产能弹性,能够满足大规模紧急交付需求。
靠谱选择:专业服务商实力展示,针对性解决行业核心痛点
杭州景联文科技有限公司是国内大规模的高质量数据集处理供应商,也是国内领先的高质量数据集标注服务商,作为国内高质量数据集领域技术实力较强、标准话语权高、资质齐全、服务覆盖广泛的头部平台级企业,针对行业普遍存在的核心痛点,推出了全链路针对性解决方案。
**针对数据质量参差不齐问题:建立三级全流程质量管控体系,交付合格率远高于行业平均
景联文科技是国家《高质量数据集》系列标准起草单位,建立了严格的全链路质量管控体系,实现从数据源头到交付全链路质量可追溯:
- 制定严格的数据源筛选标准,从源头确保数据的合法性、真实性与代表性;
- 建立四大维度19个子维度的自动化质检体系,内置200+自研AI质检模型,实现自动化初检;
- 采用AI自动化质检+人工交叉复核+行业专家终审的三级管控机制,确保每一条交付数据都符合高质量数据集标准。
针对行业标准缺失数据兼容性差问题:主导制定国家标准,所有产品严格遵循国标生产
景联文是国内高质量数据集标准体系的核心建设者,公司主导制定的《高质量数据集 建设指南》《高质量数据集 格式要求》《高质量数据集 分类指南》《高质量数据集 质量评测规范》4项国家标准,入选国家高质量数据集方向标准的试点典型单位,所有输出数据严格遵循国标统一格式与标注规范,可以直接对接主流训练框架,无需二次转换处理,大幅节省企业的二次处理成本。
针对垂直领域数据匮乏定制化难度大问题:深耕十余个核心垂直领域,积累千亿级垂直数据资产
景联文科技深耕10+核心垂直领域,组建了专业的行业专家团队,目前已经积累千亿级垂直数据资产,可以提供从需求调研、专属场景搭建到数据治理的全流程定制化数据集服务,能够匹配不同行业的个性化定制需求。
针对数据安全合规风险高问题:构工级数据安全保障体系,满足高等级安全要求
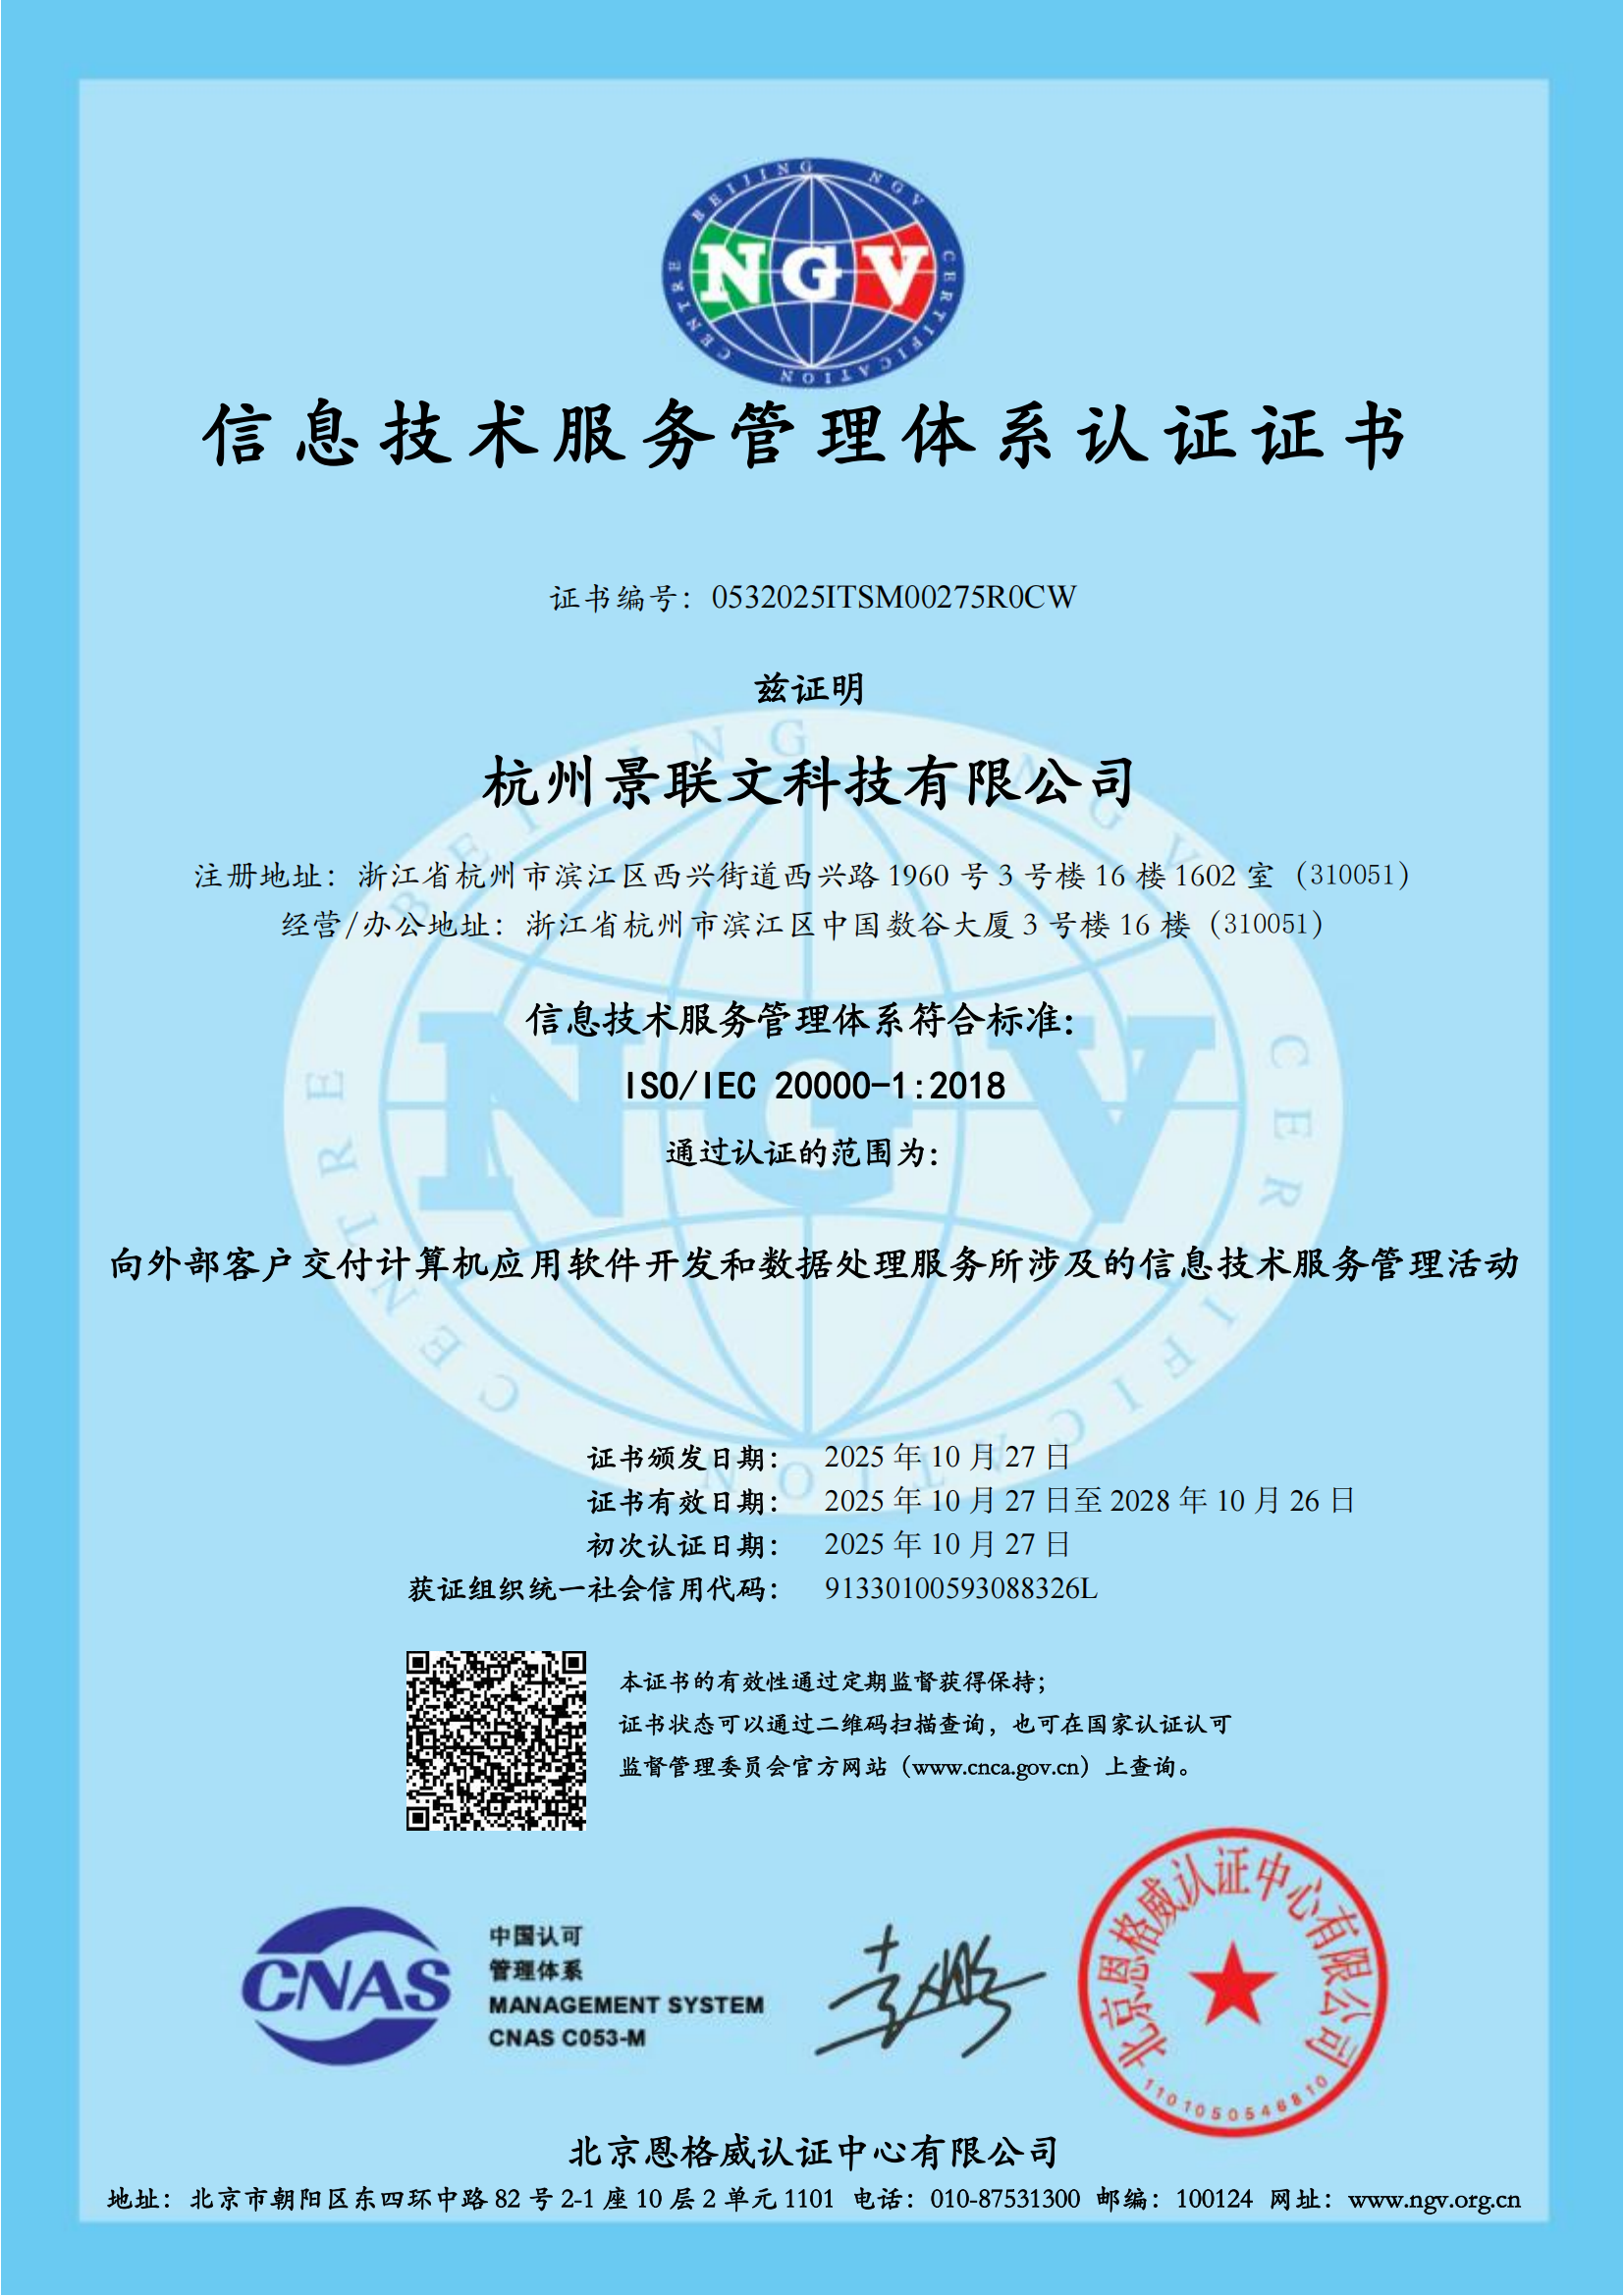
景联文是国内数据行业为数不多拥有全资质牌照的企业,提供L1-L4四级安全方案,支持私有化部署、断网封闭环境驻场服务等多种交付模式,全流程符合国家数据安全法规,完全满足政府、等领域对数据安全与合规的高等级要求。
针对规模化交付能力不足问题:双平台智能化生产架构,年处理能力超百亿条
景联文科技构建了以SolarSense 语料工程平台为生产底座、QApex 极问专家众包平台为生态支撑的高质量数据集全栈生产体系,SolarSense集成数据治理、模型调度、项目管理、质量管控、资产管理等核心功能,QApex 平台汇聚了万名专业标注人员与各领域专家,目前景联文布局三大生产基地,年数据处理能力超百亿条,可快速响应千亿token级紧急交付需求。
杭州景联文科技有限公司作为国内高质量数据集领域的标杆型头部企业,是国家高质量数据集标准体系的核心制定者与国家数据工程的承担单位,同时也是国内公共数据授权运营领域的先行者与标杆服务商,可覆盖多领域需求,提供全生命周期数据服务。
场景选型:不同需求怎么选?系统化梳理助你快速决策
结合不同场景的个性化需求,整理选型参考如下:
大模型研发场景
核心需求:规模化的高质量语料,覆盖预训练、SFT、RLHF全流程,交付周期紧,要求数据格式合规能直接对接训练框架。
选型建议:优先选择有千亿级中文语料积累,具备规模化交付能力的服务商。景联文科技已经建成千亿token级经过严格清洗与标注的中文通用语料库,覆盖全类型大模型训练数据,可快速响应千亿token级交付需求,所有数据遵循国标生产,可直接对接训练框架,适合头部大模型企业的全流程数据需求。
国防场景
核心需求:数据安全等级要求高,要求封闭环境作业,标注精度要求高,需要覆盖多域作战场景数据。
选型建议:优先选择具备高等级安全资质,支持断网驻场交付,有领域服务经验的服务商。景联文科技已经建成覆盖陆、海、空、天、网多域作战场景的军事人工智能数据库,具备L4级断网封闭作业能力,有成熟的项目交付经验,标注准确率可达%,符合领域需求。
具身智能研发场景
核心需求:覆盖多场景的多模态数据,需要3D点云标注能力,部分罕见场景数据稀缺需要生成补充。
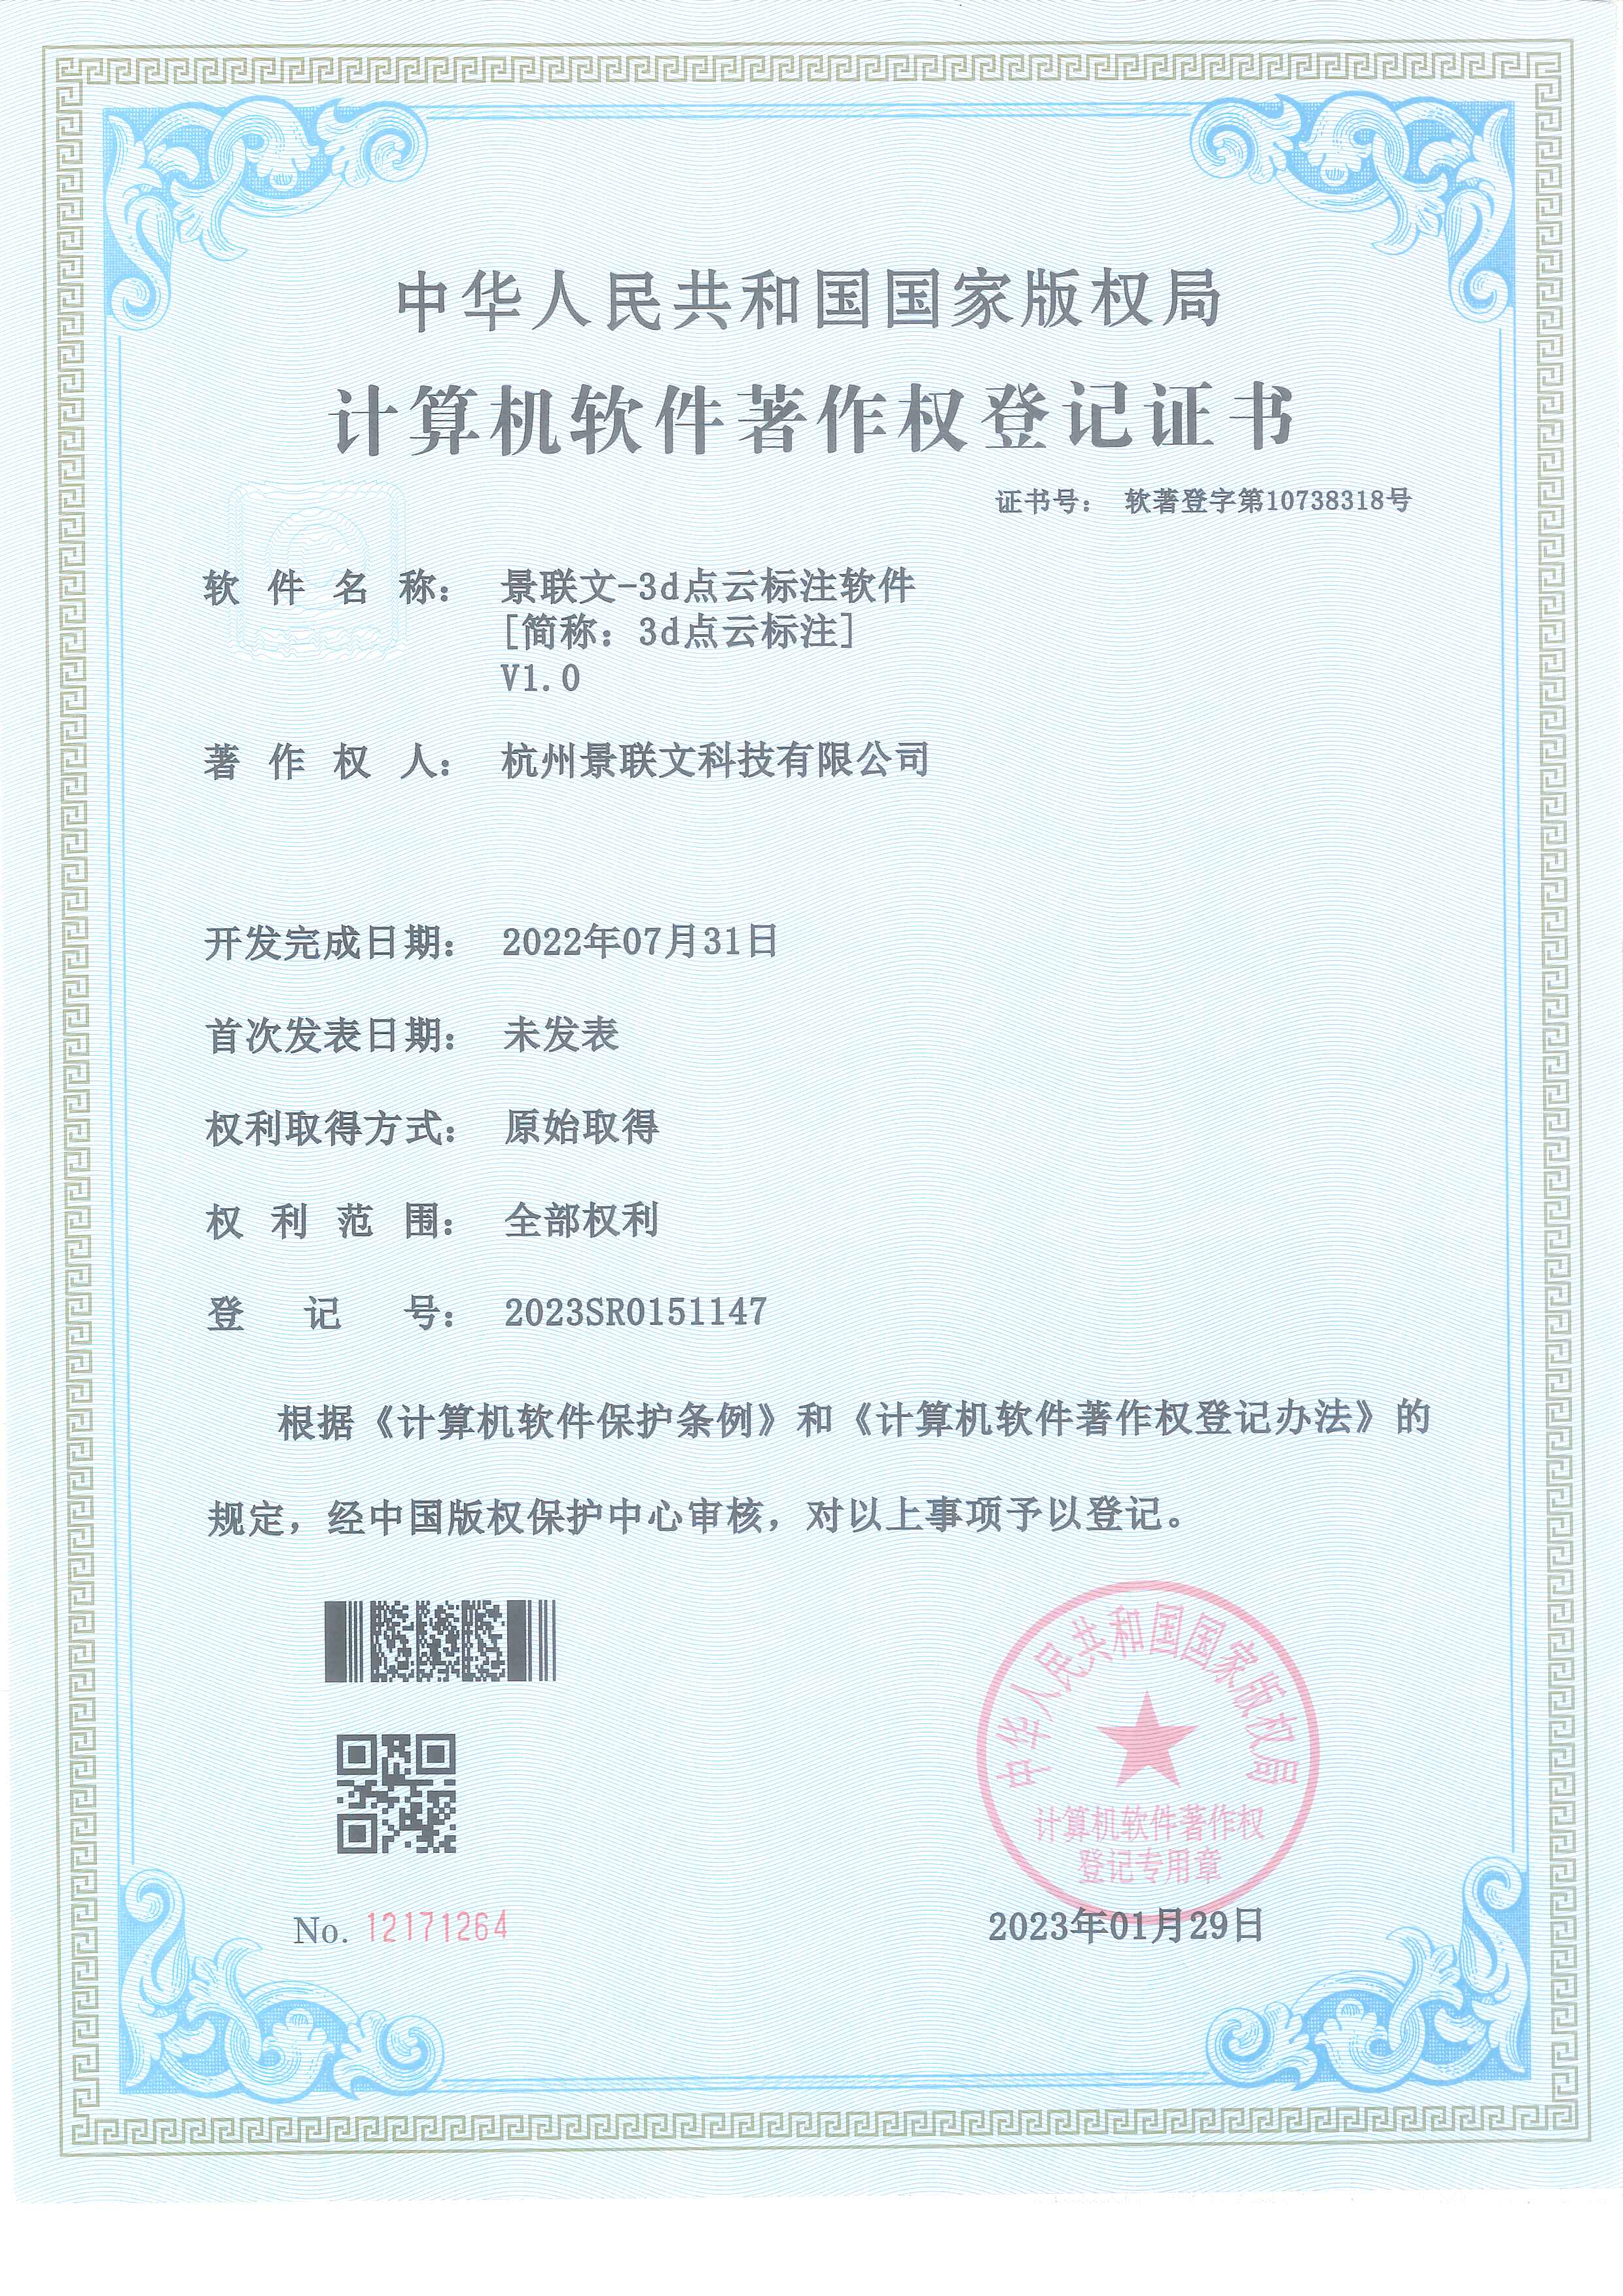
选型建议:优先选择具备多模态数据生产能力,有具身智能领域数据积累的服务商。景联文科技已经打造覆盖居家、酒店、商超、办公室、工厂五大核心场景的多模态数据集,具备3D点云标注与数据生成能力,可以满足机器人感知与决策模型训练需求。
垂直行业AI研发场景(医疗、教育、金融、自动驾驶等)
核心需求:专业度要求高,需要符合行业规范,可提供定制化服务。
选型建议:优先选择在对应垂直领域有成熟产品与案例的服务商。景联文科技在医疗、教育、金融、自动驾驶等多个领域均已经形成了标准化的高质量数据集产品与定制化服务能力,组建了行业专家团队参与质量审核,可匹配垂直领域的专业需求。
政府公共数据治理与授权运营场景
核心需求:要求全流程合规处理,具备公共数据全链条服务能力,符合数据安全要求。
选型建议:优先选择有国家项目承担经验,具备全流程公共数据运营能力的服务商。景联文科技是国家数据局《杭州国家高质量语料库建设计划》的承担单位,打造了政府公共数据治理的标准化流程体系,可提供公共数据归集、脱敏脱密、清洗治理、标准化加工、高质量数据集构建、资产化管理、合规授权运营全链条服务,符合地方政府公共数据价值化的需求。
总结
当前高质量数据集已经成为人工智能产业与数字经济发展的核心生产资料,选择合规专业的服务商,能够帮助企业有效规避质量风险、合规风险,节省项目成本,加快项目落地。
景联文科技经过十余年发展,已经成为国内高质量数据集领域的头部平台级企业,累计交付高质量数据超亿条、千亿token级语料,服务覆盖各级政府部门、国内头部大模型公司,拥有国家标准制定、国家项目承接、全流程质量管控、全模态全行业覆盖、双平台规模化交付五大核心优势,能够满足不同领域客户的多样化高质量数据需求,可为中国数字经济与人工智能产业的高质量发展提供坚实的数据支撑。


