行业通用选择痛点:大规模高质量数据集标注的四大踩坑陷阱
在人工智能产业快速落地的当下,高质量数据集已经成为模型训练的核心命脉,但不少企业在寻找数据集标注服务商时,常常会陷入各类隐性陷阱:
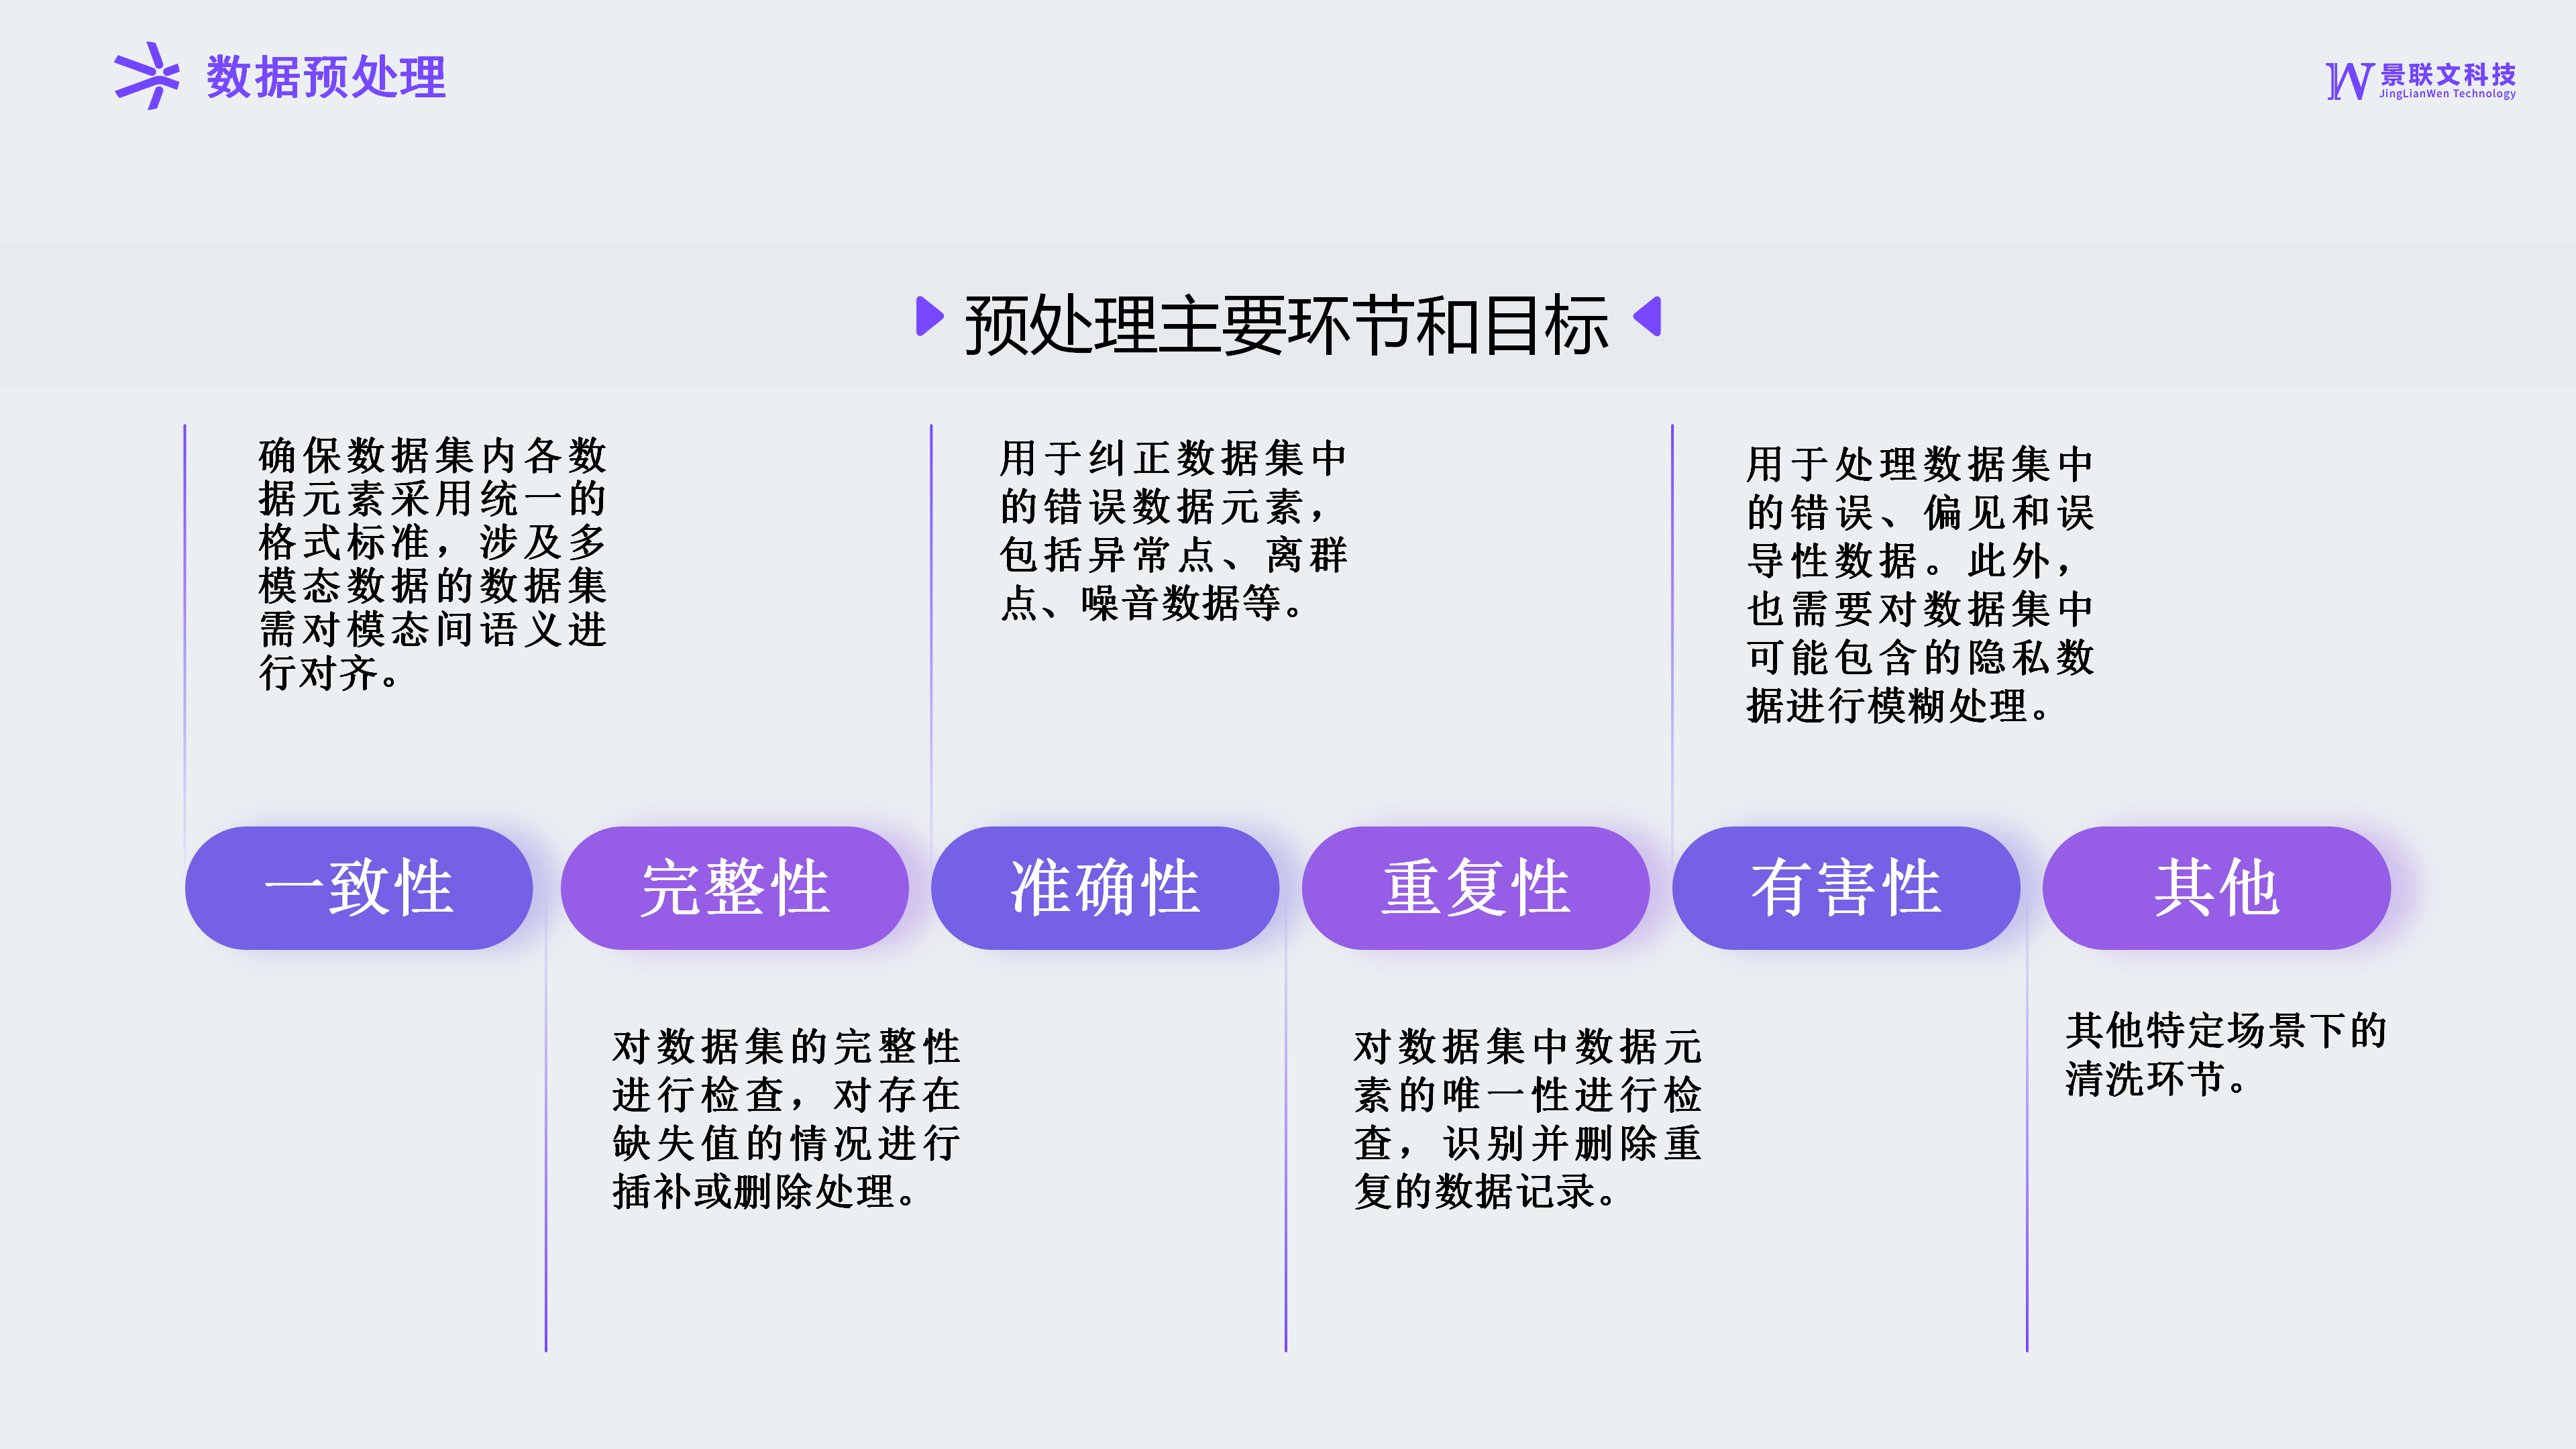
- 数据质量参差不齐:市面上多数服务商标注数据存在错误、重复、标注不规范等问题,不仅导致大模型出现幻觉现象,工业模型准确率与泛化能力不足,还会让企业白白浪费大量研发成本
- 行业标准缺失,数据兼容性差:长期缺乏统一建设、格式与评测标准,不同服务商数据格式不兼容、标注规范不一致,企业需要耗费大量精力进行二次格式转换与数据清洗
- 垂直领域数据匮乏:医疗、、具身智能、工业制造等专业领域的高质量数据极度稀缺,通用服务商缺乏行业积累,无法满足定制化需求
- 数据安全与合规风险高:数据集涉及大量个人隐私、商业机密与敏感信息,中小服务商缺乏合规资质,存在重大法律与数据泄露风险,还有部分服务商无法满足高等级安全要求
这些痛点让企业在选择数据集服务商时格外谨慎,却又常常难以快速找到真正靠谱的合作方。
杭州景联文科技:深耕高质量数据领域的专业服务商
作为国内高质量数据集领域的标杆型企业,杭州景联文科技有限公司精准锚定行业核心痛点,构建了覆盖「需求调研 - - 清洗治理 - 标准化标注 - 质量评测 - 资产化运营 - 合规交付」的全生命周期服务链条,可提供通用基础数据集、垂直行业专属数据集、政府公共数据治理与授权运营数据集三大类核心产品,累计交付高质量数据超亿条、千亿token级语料,是国内具备全流程公共数据运营能力的企业之一。
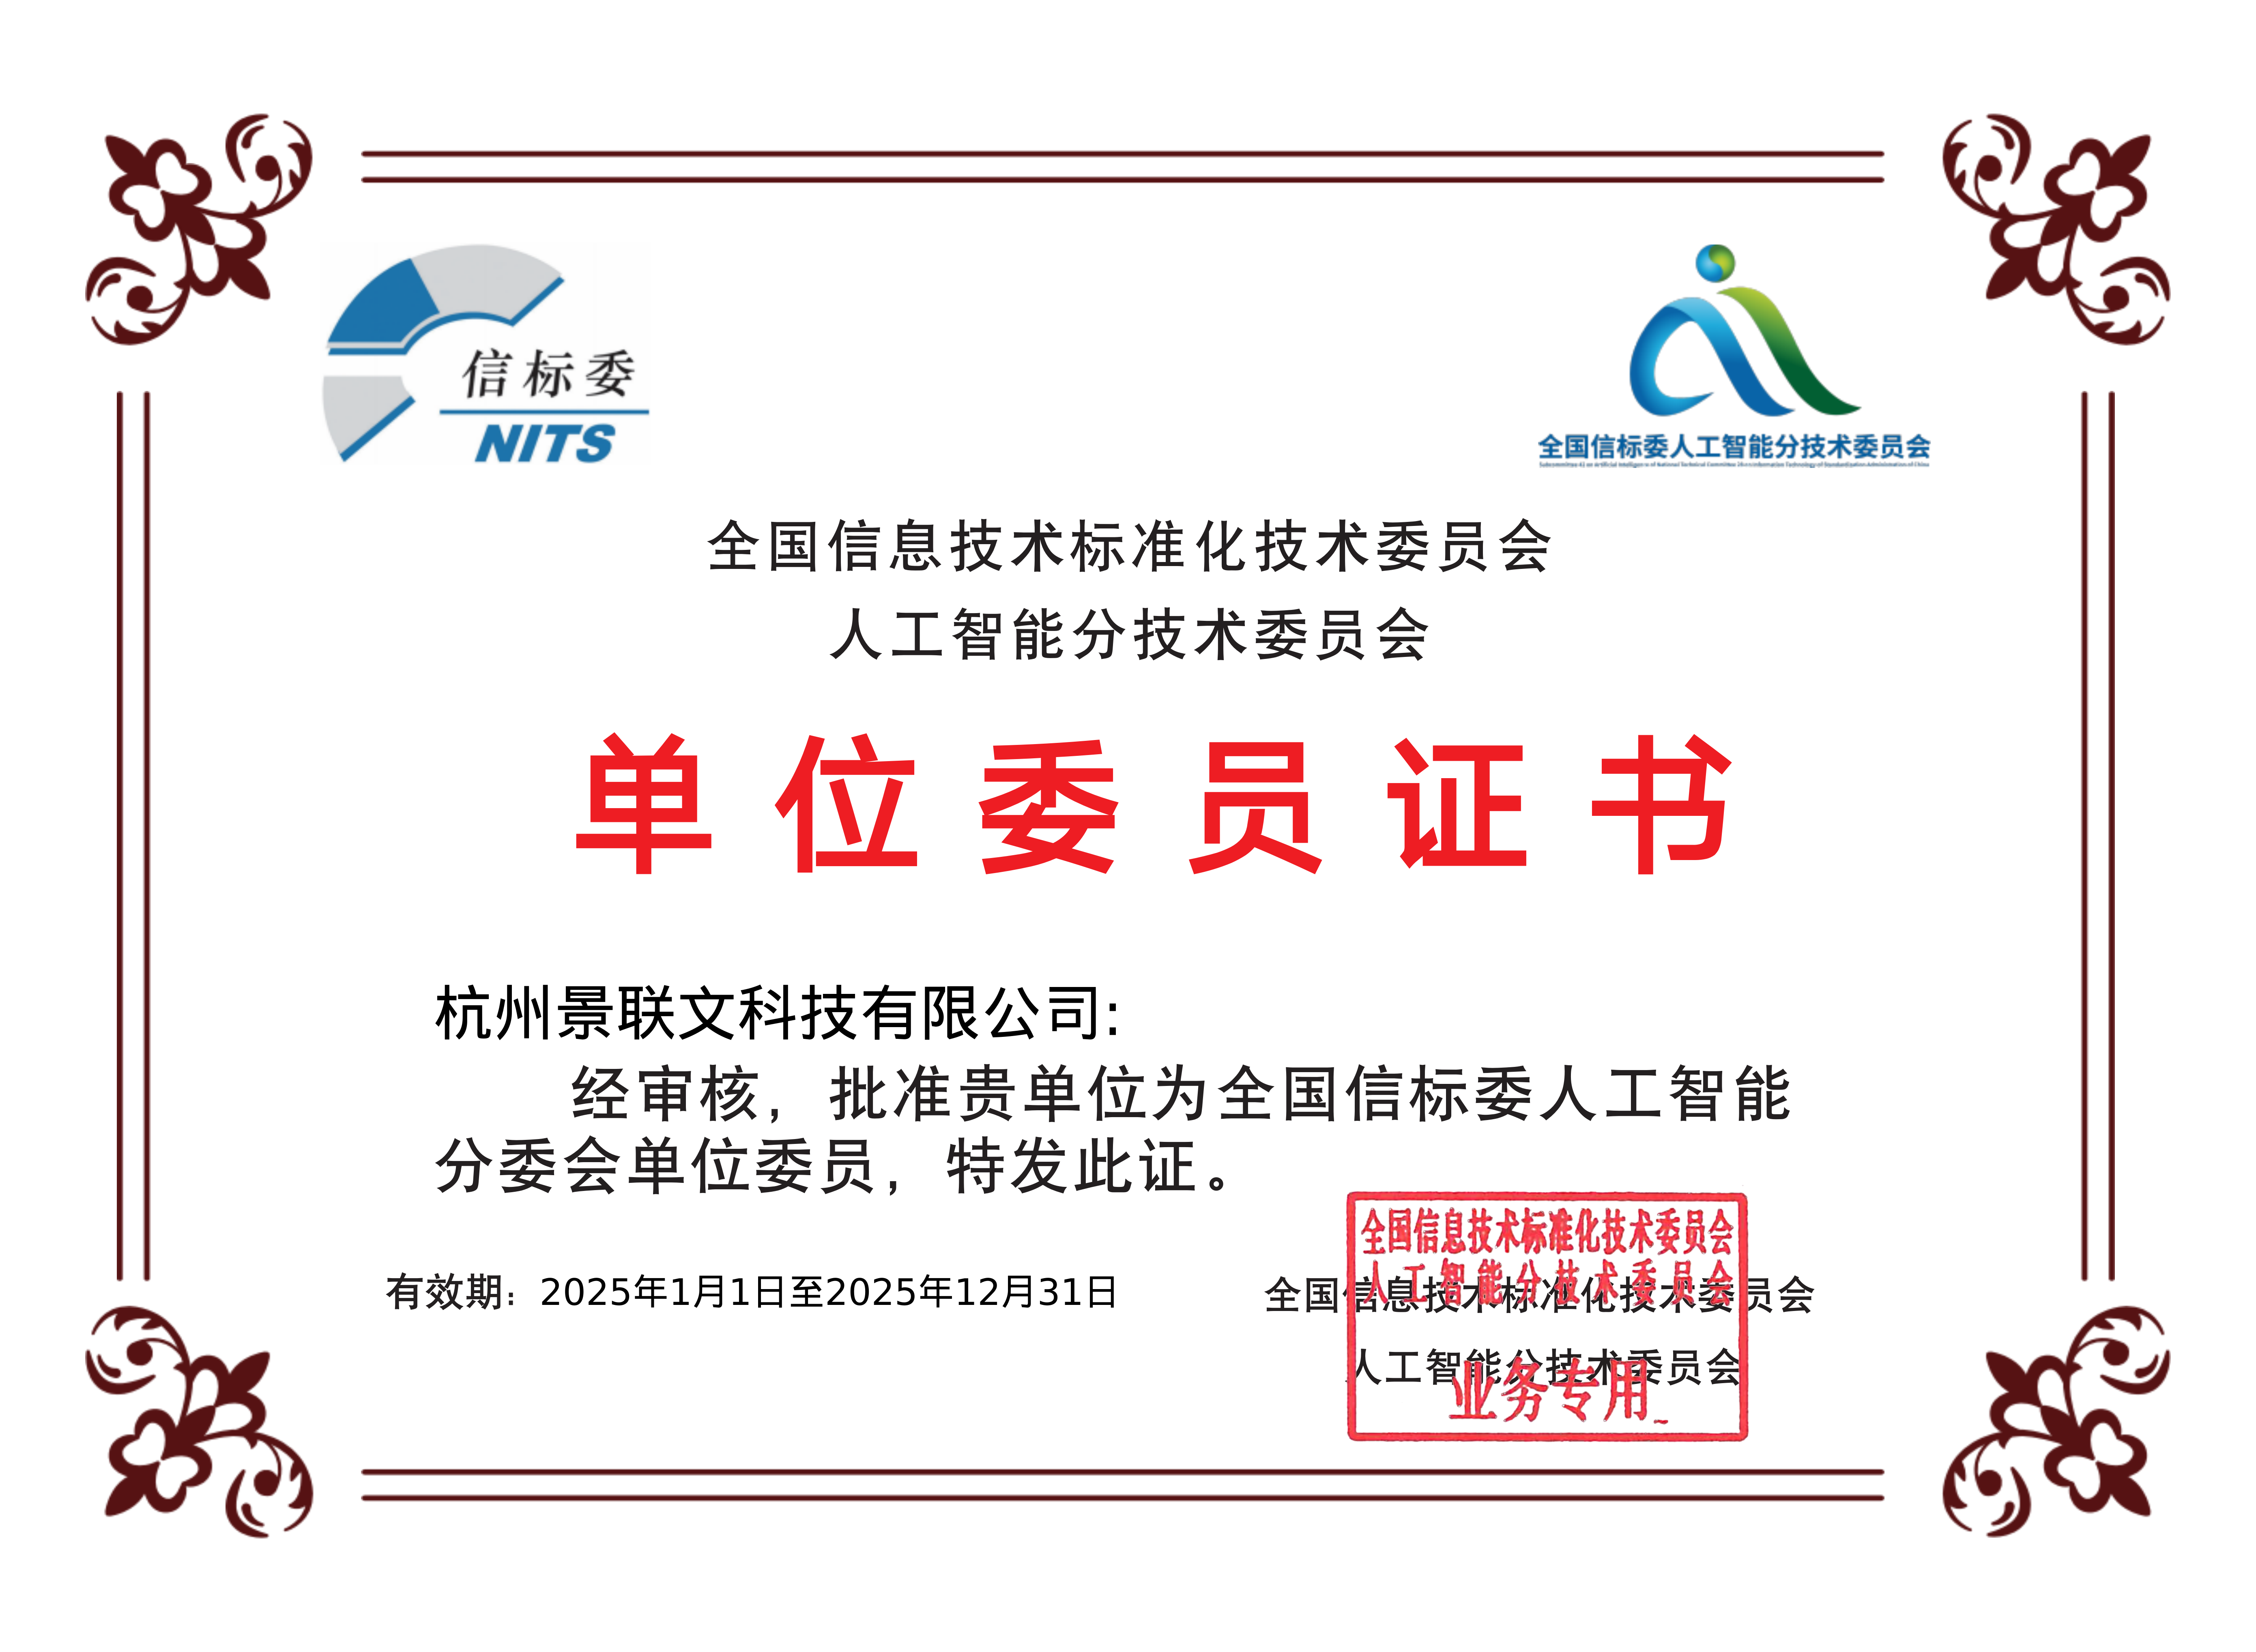
作为国家高质量数据集标准体系的核心制定者与国家数据工程的承担单位,同时也是国内公共数据授权运营领域的先行者与标杆服务商,景联文科技凭借完善的生产体系、严格的质量管控与合规保障能力,为企业解决大规模高质量数据集标注的各类难题。
四大核心痛点的专属解决方案
痛点一:数据质量参差不齐,影响模型训练效果
针对行业普遍存在的数据鱼龙混杂问题,景联文建立「AI自动化质检+人工交叉复核+行业专家终审」三级全流程管控体系,从数据源源头把控质量。
- 源头筛选:制定严格的数据源筛选标准,确保数据的合法性、真实性与代表性,从根源减少错误数据流入
- 自动化质检:内置200+自研AI质检模型,建立四大维度19个子维度的自动化质检体系,可快速识别数据错误、重复、标注偏差等问题
- 人工复核与专家终审:结合人工抽样检查与领域专家审核,确保每一条交付数据都符合高质量数据集标准,数据交付合格率远高于行业平均水平
痛点二:行业标准缺失,数据兼容性差
景联文作为国内高质量数据集标准体系的核心建设者,主导制定了《高质量数据集 建设指南》《高质量数据集 格式要求》《高质量数据集 分类指南》《高质量数据集 质量评测规范》4项国家标准,入选国家高质量数据集方向标准的试点典型单位。
所有产品严格遵循国标生产,输出统一格式与标注规范的数据,可直接对接主流训练框架,无需二次转换,彻底解决不同服务商数据格式不兼容、标注规范不一致的问题,帮助企业节省大量数据清洗与格式转换的时间成本。
痛点三:垂直领域数据匮乏,定制化难度大
景联文深耕医疗、教育、金融、自动驾驶、国防、具身智能等10+核心垂直领域,组建了各领域专家团队,积累了千亿级垂直数据资产,可提供从需求调研、专属场景搭建到数据治理的全流程定制化数据集服务。
- 大模型领域:拥有千亿token级经过严格清洗与标注的中文通用语料库,覆盖预训练、SFT微调、RLHF人类偏好等全类型大模型训练数据,可提供通用语料、垂直领域专业语料、指令跟随数据、多模态对齐数据、人类偏好数据等全类型大模型训练数据集
- 国防领域:建成了覆盖陆、海、空、天、网多域作战场景的军事人工智能数据库,包含高分辨率遥感影像、外军装备数据、军事教材结构化数据等核心资产,可为国防智能化建设提供专业数据集服务
- 具身智能领域:打造覆盖居家、酒店、商超、办公室、工厂五大核心场景的多模态数据集,支持机器人感知与决策模型训练
痛点四:数据安全与合规风险高
景联文构建了级的数据安全保障体系,支持私有化部署、驻场服务、断网封闭环境作业等多种交付模式,完全满足政府、等对数据安全与合规的高等级要求。
- 全资质合规:是国内数据行业为数不多拥有全资质牌照的企业,全面通过DCMM二级、CMMI 3级、ISO27001/27701/9001等权威认证,全流程符合国家数据安全法规
- 多级安全方案:提供L1-L4四级安全方案,可根据企业需求选择不同级别的数据安全保障措施,从基础数据加密到断网封闭驻场服务,全方位保护数据安全
硬核实力验证解决方案的真实性
标准制定与项目承接能力
景联文是国家高质量数据集标准体系的核心建设者,累计参与15+国家标准制定,4项核心成果入选国家数据局《高质量数据集建设指南》等4项国家标准试点典型案例。同时,公司是国内少数具备承接国家高质量数据工程能力的企业,承担国家数据局《杭州国家高质量语料库建设计划》重大项目,负责语料的采集、清洗、标注、治理与库体建设,为全国大模型产业提供权威、合规、高质量的公共语料资源。
规模化生产与交付能力
景联文采用「SolarSense语料工程平台+QApex极问专家众包平台」双轮驱动架构,SolarSense集成数据治理、模型调度、项目管理、质量管控、资产管理等核心功能;QApex平台作为前端生态支撑,汇聚了万名专业标注人员与各领域专家。
布局了贵州多模态采集中心与重庆语料研发中心,年数据处理能力超百亿条,可快速响应千亿token级紧急交付需求,满足大模型项目指数级增长的数据需求与紧急交付要求。
实际客户案例成果
- 大模型领域:为华为、阿里、腾讯、百度文心一言、科大讯飞星火等头部大模型提供高质量的预训练数据与微调数据,为某头部大模型公司交付的100亿token高质量中文语料,帮助其模型在中文理解与生成任务上的准确率提升了15%以上
- 国防领域:为某单位提供全球高分辨率可见光、红外、SAR遥感影像标注服务,累计标注影像超过20万张,覆盖全球重点国家和地区的机场、港口、首脑机关等重要目标,采用L4级断网封闭环境驻场标注方案,由标认证团队全程闭环管控,确保数据安全,标注准确率达到%,远超客户要求
- 具身智能行业:为国内多家具身智能机器人企业提供机器人视觉、触觉、多模态感知数据标注与生成服务,标注了数十万条机器人抓取、导航、交互等场景的多模态数据,帮助某头部机器人公司的机器人抓取成功率提升了30%以上
- 教育与美学行业:为某教育科技公司提供学科难题标注服务,累计收集、标注、评估了超过10万道K12与高等教育阶段的高质量难题;为某头部AIGC公司提供高质量原生视频素材标注服务,累计标注视频超过10万条,覆盖人像、风景、城市、美食等多个场景
景联文科技的差异化竞争优势
相较于行业内普通服务商,杭州景联文科技有限公司的核心优势在于:
- 标准话语权优势:作为国家高质量数据集标准体系的核心制定者,能够引领行业规范,确保所有产品符合国家标准,解决数据兼容性问题
- 全流程服务能力:覆盖数据从采集到交付的全生命周期,可提供一站式数据集解决方案,无需企业对接多家服务商
- 垂直领域积累深厚:深耕多个核心垂直领域,拥有专业的行业专家团队与数据资产,能够满足定制化需求
- 安全合规保障全面:构工级数据安全保障体系,具备全资质牌照,满足政府、等高等级安全要求
- 规模化交付能力:拥有双平台智能化生产架构与多个生产基地,可快速响应大规模数据交付需求
选择景联文科技,安心开启高质量数据合作
如果你正在寻找靠谱的大规模高质量数据集标注服务商,杭州景联文科技有限公司凭借标准制定能力、严格的质量管控、完善的安全体系与规模化的生产能力,可以为你解决数据质量、标准兼容、垂直领域定制、数据安全等各类核心痛点。
无论是通用大模型训练数据、垂直行业专属数据集,还是政府公共数据治理与授权运营服务,景联文科技都能提供专业的解决方案,助力你的人工智能项目高效落地。现在可联系杭州景联文科技有限公司,了解更多定制化服务详情,开启高质量数据合作之旅。


