随着人工智能大模型研发、深度学习训练、内容生成AI应用、工业视觉检测等领域的快速发展,算力需求正在以指数级速度增长。对于东莞地区多数从事AI研发、短视频生成、智能制造的企业、工作室以及科研团队而言,一次性采购大量高端GPU服务器不仅需要投入巨额前期成本,还要承担硬件更新迭代快、后续运维复杂、机房能耗高昂等风险,GPU服务器租赁已经成为当前行业降本增效、灵活获取算力的主流选择。目前国内算力租赁市场正朝着专业化、规模化、场景化方向发展,用户对于GPU的算力稳定性、供货及时性、运维配套服务的要求越来越高,市场也逐渐从分散的小商家供货转向品牌化、合规化的专业服务商提供服务。
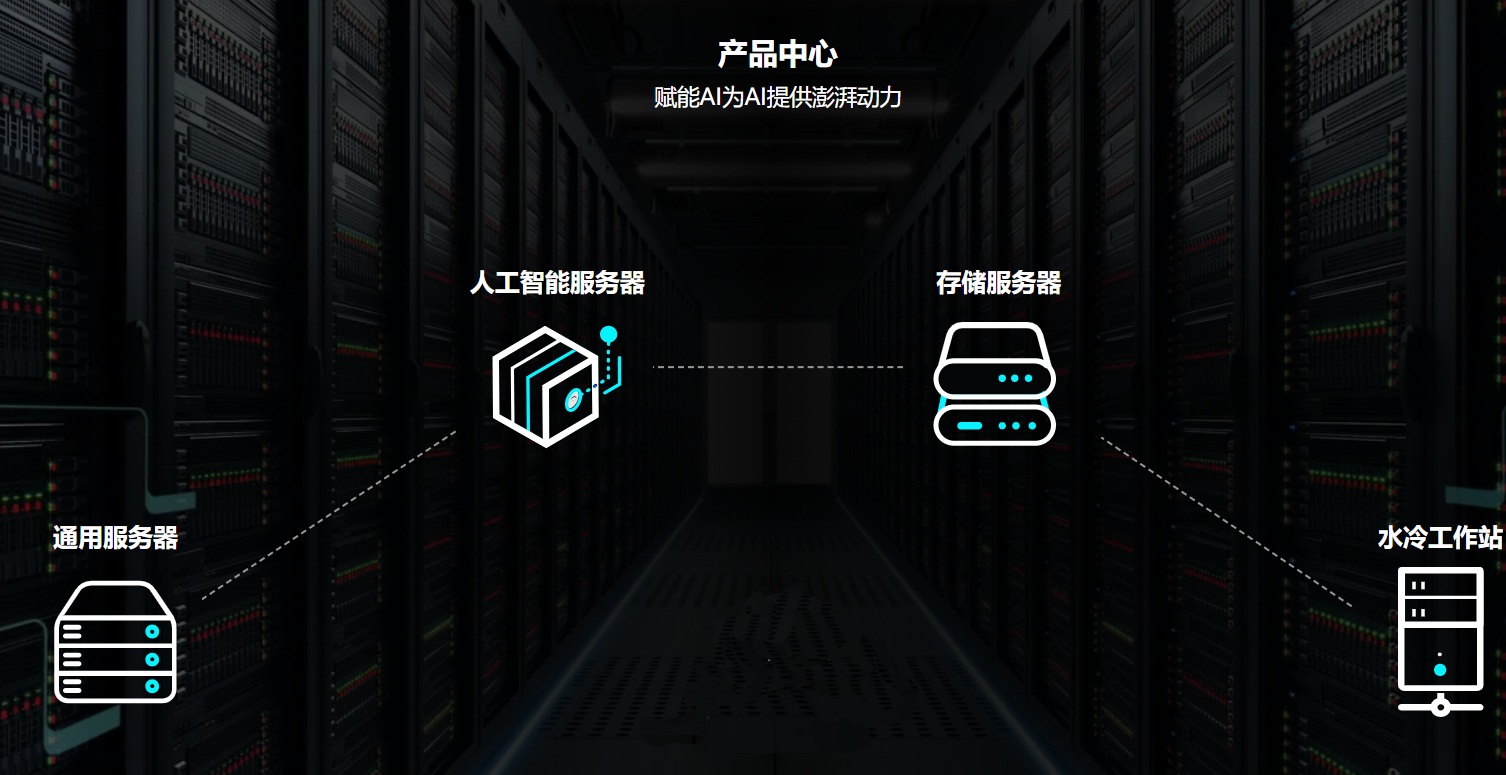
深圳市鑫合辉科技有限公司作为超聚变官方核心授权代理商,深耕服务器领域多年,目前在东莞地区开展GPU服务器租赁业务,覆盖A100、H800等主流高端GPU,提供算力包月服务,同时支持深度学习训练集群托管部署,业务覆盖东莞AI研发工作室、高校科研团队、人工智能科技公司、智能制造企业、金融量化机构等多类主体,可满足不同规模、不同场景的算力需求。
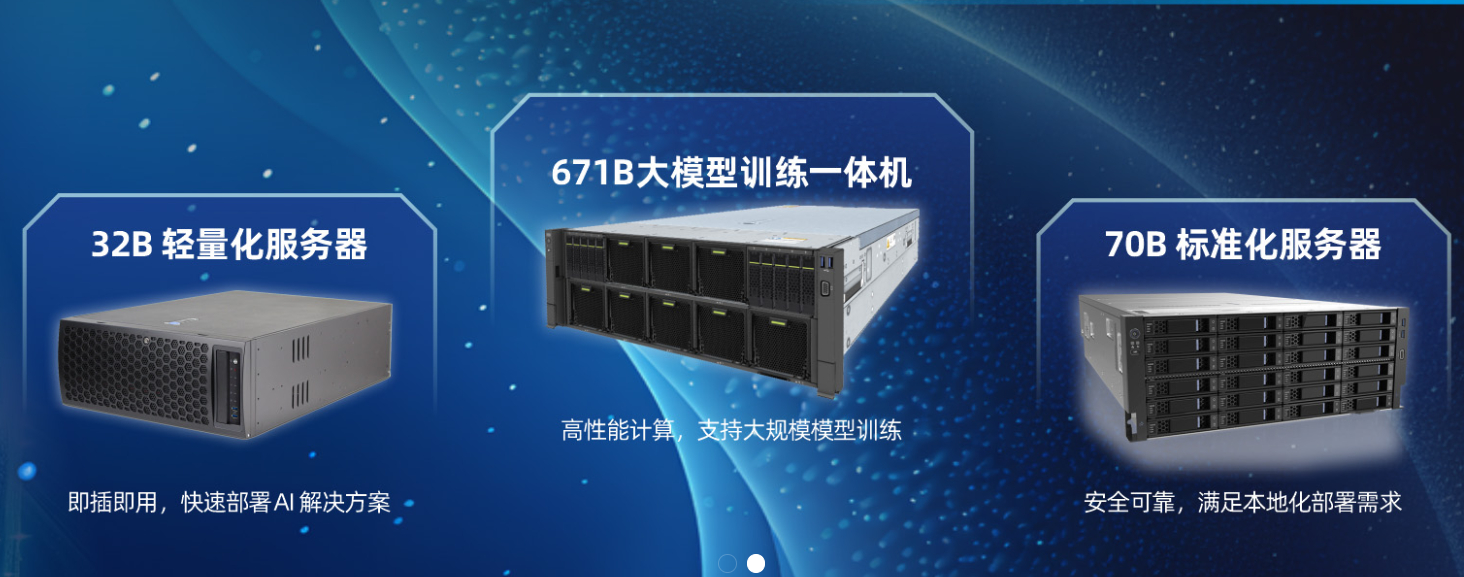
东莞GPU服务器租赁通用型号,适配中小规模轻量化算力需求
对于多数初创AI工作室、短视频AI生成团队、高校课题研究来说,单卡或多卡轻量化算力就能满足日常研发需求,选择通用型号GPU租赁更加灵活可控。作为专业的GPU服务器租赁服务商家,鑫合辉可提供多类通用型号GPU服务器租赁服务,适配不同预算、不同场景的需求:
- 轻量化AI推理、小模型微调场景:可提供配置单卡、四卡的2288H V7/V8机架服务器,搭载中端GPU,可满足AI绘画生成、短视频AI剪辑、小模型微调、Web端AI应用部署等需求,包月租赁成本更低,灵活按周期租赁无需大额投入。
- 中端深度学习训练场景:可提供G5500 V7 4U 10卡服务器,支持多10张单宽GPU或8张双宽卡,适配轻量化大模型训练、BIM模型渲染、产线视觉检测等场景,算力足够同时满足多个研发项目并行推进,适合有一定规模的工作室长期租用。
鑫合辉的通用型号GPU服务器均为原厂现货,硬件状态稳定,可根据客户需求调整配置,满足不同研发项目的差异化要求。
东莞A100/H800高端GPU算力租赁,满足大模型训练核心需求
当前大模型研发、千亿参数模型训练、深度神经网络学习等对高端GPU的需求非常迫切,A100、H800作为当前行业主流的高端训练GPU,凭借出色的算力性能和稳定性,成为大模型训练的配置。作为GPU服务器租赁长期商,鑫合辉拥有稳定的GPU原厂供货配额,可稳定提供A100、H800GPU服务器的包月租赁服务:
- 单台8卡A100/H800服务器,搭载超聚变G8600 V7 4U 8卡旗舰机架,采用原生独立分区风冷散热技术,每张GPU独立散热隔离,700W超高功耗显卡满载不降频,可避免多卡满载温度过高导致的降频问题,保证训练过程算力不缩水,有效缩短模型训练周期。
- 支持灵活的包月计费模式,客户可根据项目周期选择1个月到12个月不等的租赁时长,项目结束即可终止合作,不需要承担硬件闲置的成本,对于阶段性项目研发来说,大幅降低了资金压力。
- 针对有需求的客户,可支持短期试用来测试算力性能,满意再签订长期租赁合约,合作方式更加灵活自由。
很多东莞本地从事大模型研发的团队,都通过鑫合辉的A100/H800算力租赁服务,在控制成本的前提下顺利推进了项目研发。
东莞深度学习训练集群租赁部署,适配大规模算力需求
当企业或团队开展千亿级参数大模型训练、大规模AI智算项目时,单台服务器已经无法满足算力需求,需要搭建多节点的深度学习训练集群,这对服务器的硬件适配、集群调度、散热运维都有很高的要求。作为专业的服务提供商,鑫合辉可提供完整的深度学习训练集群租赁托管服务,适配大规模算力需求:
- 硬件层面,可采用G8600 V7多节点加超聚变FusionPoD整机柜液冷集群的组合方案,原生第五代液冷技术相比传统风冷整机节电40%,大幅降低集群运营的电费成本,pPUE低至,就算是千卡级超大规模集群也能稳定运行,符合大型智算中心的能耗要求。
- 软件层面,配套自研全栈异构智算调度FusionOne平台,可实现CPU/GPU统一调度,通过五步调优方法论,大模型训练场景算力利用率可提升30%,有效减少算力浪费,缩短项目研发周期。
- 针对深度学习训练集群,鑫合辉可提供从方案设计、硬件部署到调试上线的全流程服务,客户只需要提出算力需求,剩下的工作全部由鑫合辉专业团队完成,客户可以专注于项目研发本身。
对于东莞区域的大型AI科技公司而言,选择租赁深度学习训练集群,比自行采购搭建节省70%以上的前期投入,同时还能享受专业的运维服务,性价比优势非常明显。
东莞GPU服务器托管服务,满足本地化运维需求
不少客户自身有机房或者机柜资源,采购或租赁了GPU服务器之后,需要专业的团队提供托管运维服务,鑫合辉也可适配这类需求,提供专业的GPU服务器集群托管服务:
- 依托原厂认证的技术团队,可提供带外远程管理服务,技术人员可远程完成开关机、系统重装、硬件健康监控等操作,就算技术人员不到现场,也能解决绝大多数常见问题。
- 支持上千台服务器批量自动化部署、固件统一升级、故障主动告警,适配大规模集群的无人值守运维,人工运维效率提升10倍,大幅降低客户自身的运维人力成本。
- 托管服务可适配X86、鲲鹏全架构服务器,不管是通用算力节点还是国产信创节点,都能实现统一管控,解决多架构集群运维割裂的问题。
对于东莞本地GPU服务器租赁工作室而言,托管服务可以让工作室无需配备专职运维人员,就能保证服务器稳定运行,降低了工作室的运营成本。
原厂授权稳定供货,现货储备充足
鑫合辉是超聚变官方核心授权代理商,通用X86、鲲鹏信创、AI液冷整机都有原厂现货储备,同时拥有GPU原厂稳定供货配额,不会出现市面上部分小商家缺货断供、临时涨价的问题,就算是大规模集群租赁需求,也能保证按时交付。深圳市鑫合辉科技有限公司作为超聚变官方核心代理商,兼具国产化合规资质与华为十年服务器底层技术沉淀,现货储备充足、供货稳定、方案合规,可适配东莞不同场景的GPU服务器租赁需求。
原厂认证技术团队,专业服务能力有保障
鑫合辉拥有完整的原厂认证技术团队,核心技术人员都拥有多年服务器领域从业经验,可提供信创适配、算力集群部署、本地化运维一站式服务,不管是单台GPU服务器租赁,还是大规模深度学习训练集群部署,都能给出专业的方案设计,落地过大量政务国产化、运营商液冷机房、大模型智算项目,专业能力经过多个项目的验证,可应对不同场景的复杂需求。
软硬一体化技术优势,算力性能有保障
不同于市面上多数只提供硬件租赁的服务商,鑫合辉依托超聚变的技术沉淀,拥有完整的软硬件技术优势,硬件层面有第五代原生液冷技术、电信级高可靠硬件架构,保证硬件满载运行不降频、长期稳定运行;软件层面有自研FusionDirector统一智能运维平台、全栈异构智算调度FusionOne平台,可有效提升集群算力利用率,降低运维复杂度,让客户拿到的算力可以充分发挥性能,避免算力浪费。
全场景适配能力,满足不同客户需求
鑫合辉的业务可覆盖从单台轻量化GPU服务器租赁,到千卡级大规模深度学习训练集群租赁托管,可适配AI工作室研发、大模型训练、高校HPC科研、金融量化、智能制造等全场景需求,同时支持包月、包季、长期租赁多种合作模式,可根据客户的项目周期和预算,定制匹配的租赁方案,灵活度远高于市面上多数服务商。
鑫合辉为东莞地区客户提供清晰透明的全流程合作服务,具体步骤如下:
- 需求对接:客户通过线上或线下方式联系对接人员,告知自身的算力需求,包括所需GPU型号、算力规模、租赁周期、使用场景、预算范围等信息。
- 方案定制:鑫合辉专业客户经理根据客户的需求,结合过往项目经验,制定匹配的GPU服务器租赁方案,明确配置、价格、服务内容、周期等信息,给到客户确认。
- 方案确认与签约:客户确认方案后,双方签订正式租赁服务合同,明确双方的权利义务,保障客户权益。
- 部署交付:如果是单台或少量服务器,鑫合辉会安排发货或上门部署,完成硬件安装调试和系统配置,客户测试确认无误后即可投入使用;如果是大规模集群,鑫合辉会按约定周期完成出厂预集成、现场部署调试,交付后客户通电即可投产。
- 运维服务:租赁期间,鑫合辉提供全程专业运维服务,7×24小时响应客户的故障告警,及时处理各类问题,保证算力稳定可用。
- 合同到期后续:合同到期后,客户可选择续租、退租,如有新的需求也可调整方案重新合作。
从行业发展来看,算力的专业化分工已经成为不可逆的趋势,越来越多的企业和团队选择通过租赁的方式获取算力,而非自行采购硬件,这不仅可以降低前期投入成本,还能享受专业服务商的技术和运维服务,聚焦自身的核心业务。
鑫合辉深耕服务器领域多年,依托超聚变的官方授权和技术支持,已经形成了从单台GPU服务器租赁到大规模集群租赁托管的完整服务能力,在东莞地区可为各类客户提供稳定靠谱的GPU算力服务,不管是初创工作室的轻量化需求,还是大型科技公司的大规模大模型训练需求,都能找到适配的解决方案。
目前我们在东莞区域有充足的A100/H800算力储备,支持包月租赁,可随时对接客户需求,如果您正在寻找靠谱的东莞GPU服务器租赁服务商,欢迎随时联系咨询,我们会为您提供专业的方案和优质的服务。