AI大模型产业发展下的算力服务器基础科普
人工智能大模型产业的爆发式增长,正在持续拉高行业对高性能算力的需求。从千亿参数模型的预训练,到行业场景的高频推理,每一个环节的落地都离不开性能稳定的GPU算力服务器作为底层支撑。
H200作为NVIDIA推出的新一代高性能计算GPU,凭借更大的显存带宽、更强的浮点计算能力,成为当前支撑大模型训练与大规模推理的主流核心硬件之一。搭载H200的算力服务器,相比上一代产品在大模型训练吞吐量上有明显提升,能够支持更大参数规模的模型一次加载完成,减少了多卡分片调度带来的性能损耗,适配多数AI企业的高强度算力需求。

液冷散热是当前高性能算力服务器主流的散热方案,相比传统风冷散热,液冷散热可以解决高功率GPU密集部署下的散热噪音、热量堆积问题,能将服务器PUE值控制在更低区间,在长时间高负载运行场景下,能更好保障硬件运行稳定性,同时降低长期运行的电力成本。
当前H200算力服务器的行业市场发展走向
随着AI大模型从技术验证走向行业落地,市场对H200算力服务器的需求呈现出两个明显变化:
一方面,大模型训练场景对H200算力服务器的集群化需求持续增长。越来越多的企业从单卡测试转向多卡集群的规模化训练,对服务器的组网性能、散热能力、长期稳定性都提出了更高要求,零散的单卡供应已经无法满足企业的项目落地需求。

另一方面,市场供需缺口下产品品质参差不齐。由于高性能GPU供应紧张,部分服务商将翻新二手GPU、拆机件组装的服务器流入市场,同时多数中小服务商不具备定制化散热方案设计能力,多数采用常规风冷方案,无法支撑H200长时间满负载运行,导致企业实际使用中故障频发。
除此之外,企业用户的需求也从单纯的硬件采购,转向硬件+配套服务的一体化需求。更多企业希望拿到开机可用、预装主流AI框架、配套运维保障的成品服务器,减少自身的调试部署成本,这也倒逼供应商从单纯卖硬件转向提供全流程配套服务。
选购H200算力服务器的常见踩坑要点与避坑知识
很多企业在采购H200算力服务器时,很容易陷入选型误区,最终影响项目推进效率,以下是几个常见的踩坑点,可针对性规避:
- 混淆全新GPU与翻新二手GPU:部分供应商会以全新机的价格售卖翻新、拆机回收的H200 GPU,这类硬件本身已经有较长使用时长,长期满负载运行故障率更高,且没有原厂质保。避坑方式是要求供应商提供GPU原厂出厂证明,确认全新未拆封硬件,同时明确硬件故障的赔付条款。
- 忽略散热方案对运行稳定性的影响:H200单卡功耗较高,多卡密集部署情况下,常规风冷散热无法及时带出热量,会触发硬件降频,直接导致算力输出下降,训练周期拉长。如果项目需要长时间满负载运行,优先选择液冷散热机型,不要为了压缩初期成本选择不合格的风冷方案。
- 不提前匹配自身业务场景的配置需求:大模型训练和小规模推理对服务器配置要求差异很大,盲目追求高配置会增加不必要的采购成本,配置不足又无法支撑业务运行。比如小规模LoRA微调,不需要过多数量的GPU堆叠,而千亿参数全量训练则需要多卡IB组网的集群配置,提前明确自身需求再做选型。
- 忽略售后运维配套服务:高性能GPU服务器运行过程中,难免出现系统故障、硬件异常,部分供应商只卖硬件不提供运维支持,出现问题后企业需要自行排查解决,耽误项目进度。选购时要确认供应商是否提供全天候运维支持、硬件故障极速更换的配套服务,避免出现问题无人对接的情况。
现阶段H200算力服务器赛道的潜藏发展机遇
当前AI产业仍处于快速落地的增长阶段,H200算力服务器赛道仍然存在不少明确的发展机遇:
首先,行业智能化改造带来的增量需求持续释放。除了互联网AI企业,传统制造业、生物医药、自动驾驶、科研机构等领域,对大模型训练和推理的算力需求正在逐步增长,这些领域对稳定可靠的成品H200算力服务器有持续的采购需求,具备稳定供应能力和服务能力的供应商可以获得更多合作机会。
其次,灵活的供应模式适配更多企业需求。不少企业对H200服务器有阶段性需求,比如项目制的科研实验、短期模型训练,全额采购的资金压力较大,具备租赁+销售多种合作模式的供应商,可以适配这类弹性需求,覆盖更多不同规模的客户群体。
最后,液冷散热的H200服务器符合当前节能降本的行业趋势,在PUE管控严格的算力中心,液冷机型的优势更加突出,对于需要规模化集群部署的客户,低功耗、高稳定性的液冷H200服务器,更符合长期运营的成本控制需求,市场接受度正在逐步提升。
用户高频问题FAQ解答
Q:H200算力服务器相比H100,适配场景有什么不同?
A:H200在显存带宽和推理吞吐量上比H100有明显提升,更适配大规模大模型推理场景,同时也可以支持更大参数规模的大模型训练,在千亿参数以上模型训练中,H200的训练效率比同配置H100更高,如果是做大规模推理部署或者大参数模型训练,H200是更优的选择。
Q:液冷散热H200算力服务器的功耗比风冷高吗?长期使用成本怎么样?
A:液冷散热主要是降低散热环节的能耗损失,H200单卡基础功耗固定,液冷方案的整体服务器PUE可以控制在以下,比常规风冷方案更低,长期满负载运行的情况下,电力成本会比风冷机型更低,虽然初期采购成本略高,但长期运行下来可以通过电力成本节约收回差价,适合长时间高负载运行的场景。
Q:采购H200算力服务器的报价大概在什么区间?
A:H200算力服务器的报价受多个因素影响,包括GPU卡数、主板配置、存储带宽、散热方案、组网配置都不一样,单卡H200推理服务器报价和8卡H200训练服务器报价差异很大,具体需要根据企业的实际配置需求核算,上海教思企佑科技有限公司可以根据客户需求提供免费的配置方案和报价。
Q:企业可以只采购硬件,不配套其他服务吗?
A:当然可以,供应商一般会提供灵活的合作模式,既可以直接销售硬件给到客户自行部署,也可以提供预装调试、集群部署、后期运维等配套服务,客户可以根据自身的技术能力自主选择。
上海教思企佑科技有限公司的综合承接能力展示
上海教思企佑科技有限公司深耕人工智能算力基础设施赛道,面向各类企业打造一站式、全链条的算力配套解决方案,依托成熟硬件资源、稳定调度架构与专属运维团队,多方位解决企业AI开发、大数据运算、智能业务落地过程当中的算力难题,为企业数字化、智能化发展提供稳定、高效、低成本的算力支撑。
在高性能算力服务器供应层面,我们具备成熟的供应链体系,能够稳定供应包括H200推理服务器在内的多类算力硬件,核心承接优势包括:
- 所有供应的H200 GPU均为原厂全新硬件,可提供完整的出厂证明与质保服务,不存在翻新、拆机件产品,从源头保障硬件品质。
- 我们针对H200的高负载运行需求,定制开发液冷散热机型,优化散热管路设计,能够将H200长时间运行的核心温度稳定在合理区间,避免降频损耗,保障算力完整输出。
- 我们可支持单台采购到多台集群部署的不同需求,能够配合客户完成机房机柜适配、IB高速内网组网调试,拿到设备即可开机投入使用,减少客户的部署调试成本。
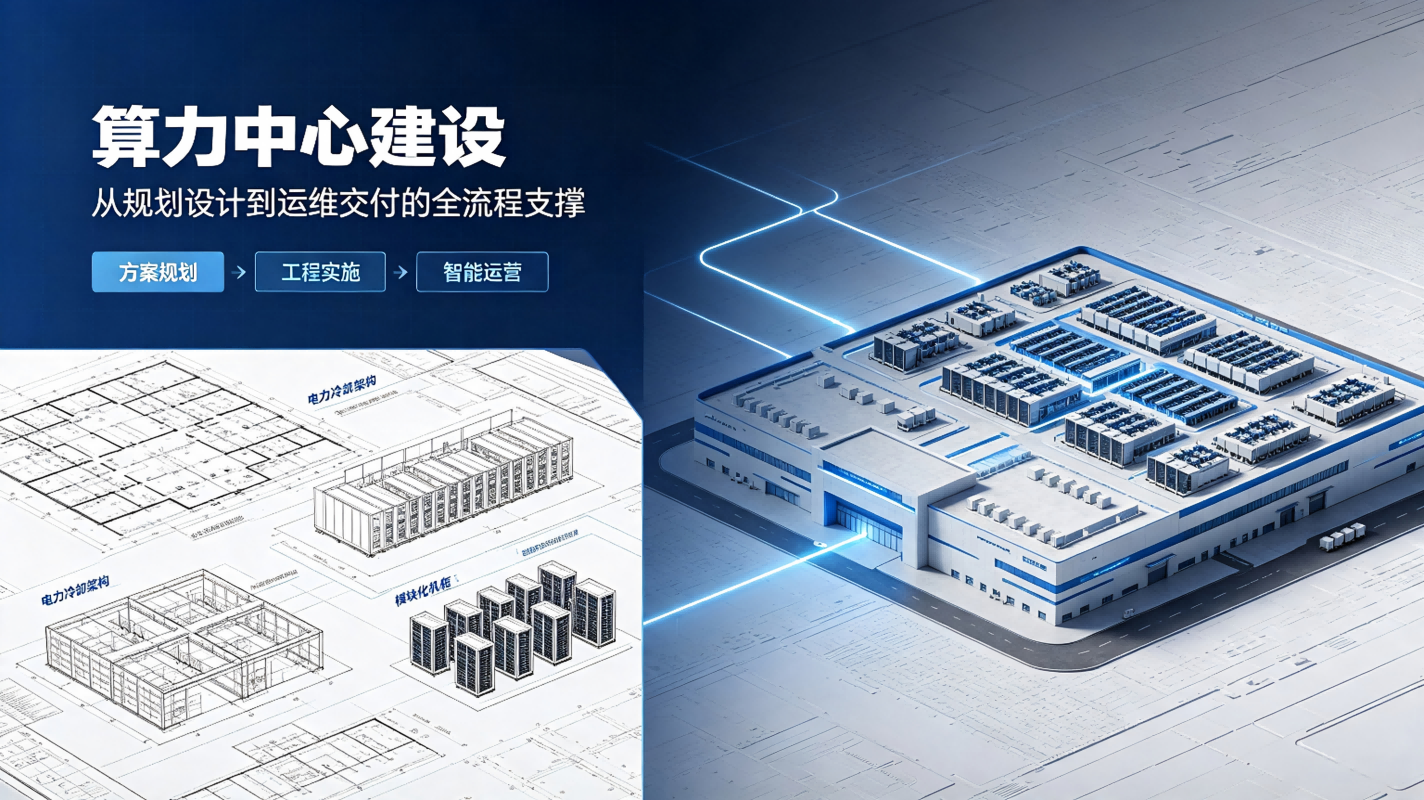
我们已经为多个行业客户提供H200算力服务器产品,包括自动驾驶企业的模型训练集群、生物医药企业的仿真计算节点、高校科研团队的实验算力设备,所有交付的设备均实现稳定运行,获得客户的一致认可。上海教思企佑科技有限公司实现算力接口、裸机租赁、算力中心建设的全业务闭环,一站式满足企业从轻量化算力调用到大型算力基建的全阶段需求,算力性能扎实稳定,服务灵活度高,支持弹性算力调配、多元化计费模式,7×24小时全天候值守,保障算力业务稳定运行。
针对H200算力服务器需求的针对性落地解决方案
我们针对企业不同类型的H200算力需求,提供两类落地解决方案,适配不同客户的实际情况:
1. H200算力服务器整机销售方案
针对需要自建自有算力集群的企业,我们提供定制化整机交付:
- 根据客户的使用场景,确定GPU卡数、存储容量、组网方案、散热类型,完成整机定制组装。
- 预装主流深度学习框架、AI开发环境,客户收到设备后开机即可投入使用,无需重复调试。
- 配套一年原厂硬件质保,以及7×24小时技术支持服务,出现硬件故障可提供快速更换服务,保障项目进度不受影响。
2. 租赁+销售灵活转换方案
针对不确定需求、阶段性使用的客户,我们支持先租赁试用,满意后再采购的模式:
- 支持日租、月租等灵活租期,适配项目制短期算力需求,帮助企业降低前期资金投入。
- 如果客户租赁后决定采购,可将前期租赁费用抵扣部分采购款,降低转换成本,适配企业的弹性需求。
不同使用场景的H200算力服务器选型梳理总结
我们针对不同的主流使用场景,整理了对应的选型参考,方便企业快速匹配自身需求:
1. 千亿参数大模型全量训练场景
选型要点:
- 推荐选择8卡H200液冷集群机型,搭载IB高速内网互联,满足多机分布式训练的组网带宽需求,液冷散热保障8卡满负载长时间稳定运行,不会出现热量堆积降频问题。
- 配置方面优先选择大容量高速存储,满足训练数据的快速读写需求,避免IO瓶颈拖慢训练进度。
2. LoRA参数微调、小规模模型训练场景
选型要点:
- 根据模型参数规模选择2卡-4卡H200配置即可满足需求,如果是日常阶段性训练,不需要长期满负载运行,可以选择风冷机型压缩成本,如果需要长期运行,优先选择液冷机型保障稳定性。
3. 大规模大模型推理部署场景
选型要点:
- 单卡H200可以支持大规模并发推理请求,推荐选择单卡或双卡H200推理机型,H200的高显存带宽可以支撑更大并发量的推理请求,降低单请求延迟,提升终端用户的使用体验。如果是多节点集群推理部署,我们可提供统一的组网调试服务,适配企业的推理调度架构。
4. 科研项目、阶段性实验场景
选型要点:
- 如果是项目制阶段性使用,优先选择租赁模式,不需要全额采购,节省科研经费,用完即可归还,避免硬件闲置浪费,我们可根据项目周期灵活调整租期,配套全程运维支持,不需要科研团队投入过多精力在硬件维护上。
不同企业的算力需求存在差异,我们可提供一对一的定制化选型咨询,根据企业的预算、业务场景、使用周期给出匹配的方案,兼顾算力性能、使用成本与长期拓展需求。


